


DeepSeek heeft op 10 september V4.1 Flash uitgebracht. Het model is via de API, de koppeling voor ontwikkelaars, beschikbaar onder de naam deepseek-flash. De bijbehorende modelkaart beschrijft ondersteuning voor tekst en afbeeldingen als invoer; de antwoorden bestaan uit tekst.
Pro-aanvragen krijgen een ander model
Vanaf 14 september om 06.00 uur Nederlandse en Belgische tijd worden alle aanvragen voor deepseek-v4-pro doorgestuurd naar V4.1 Flash. Volgens DeepSeek geldt dan ook het Flash-tarief. Die situatie blijft bestaan totdat het bedrijf V4.1 Pro uitbrengt.
Oude Flash-namen blijven tijdelijk werken
De vorige V4 Flash en V4 Flash Vision Exp zijn al teruggetrokken. Hun bestaande API-namen verwijzen tijdelijk naar de opvolger. Wie een oude modelnaam blijft gebruiken, krijgt daardoor niet vanzelf hetzelfde model als voorheen.
Ruimte voor lange invoer
In de modelkaart noemt DeepSeek een contextvenster van maximaal één miljoen tokens. De architectuur verwerkt die invoer anders dan het antwoord: volgens DeepSeek zijn tijdens de invoerverwerking acht miljard parameters actief en tijdens het genereren zestien miljard.
Meer weten?
Kies de verdieping die je interessant vindt.
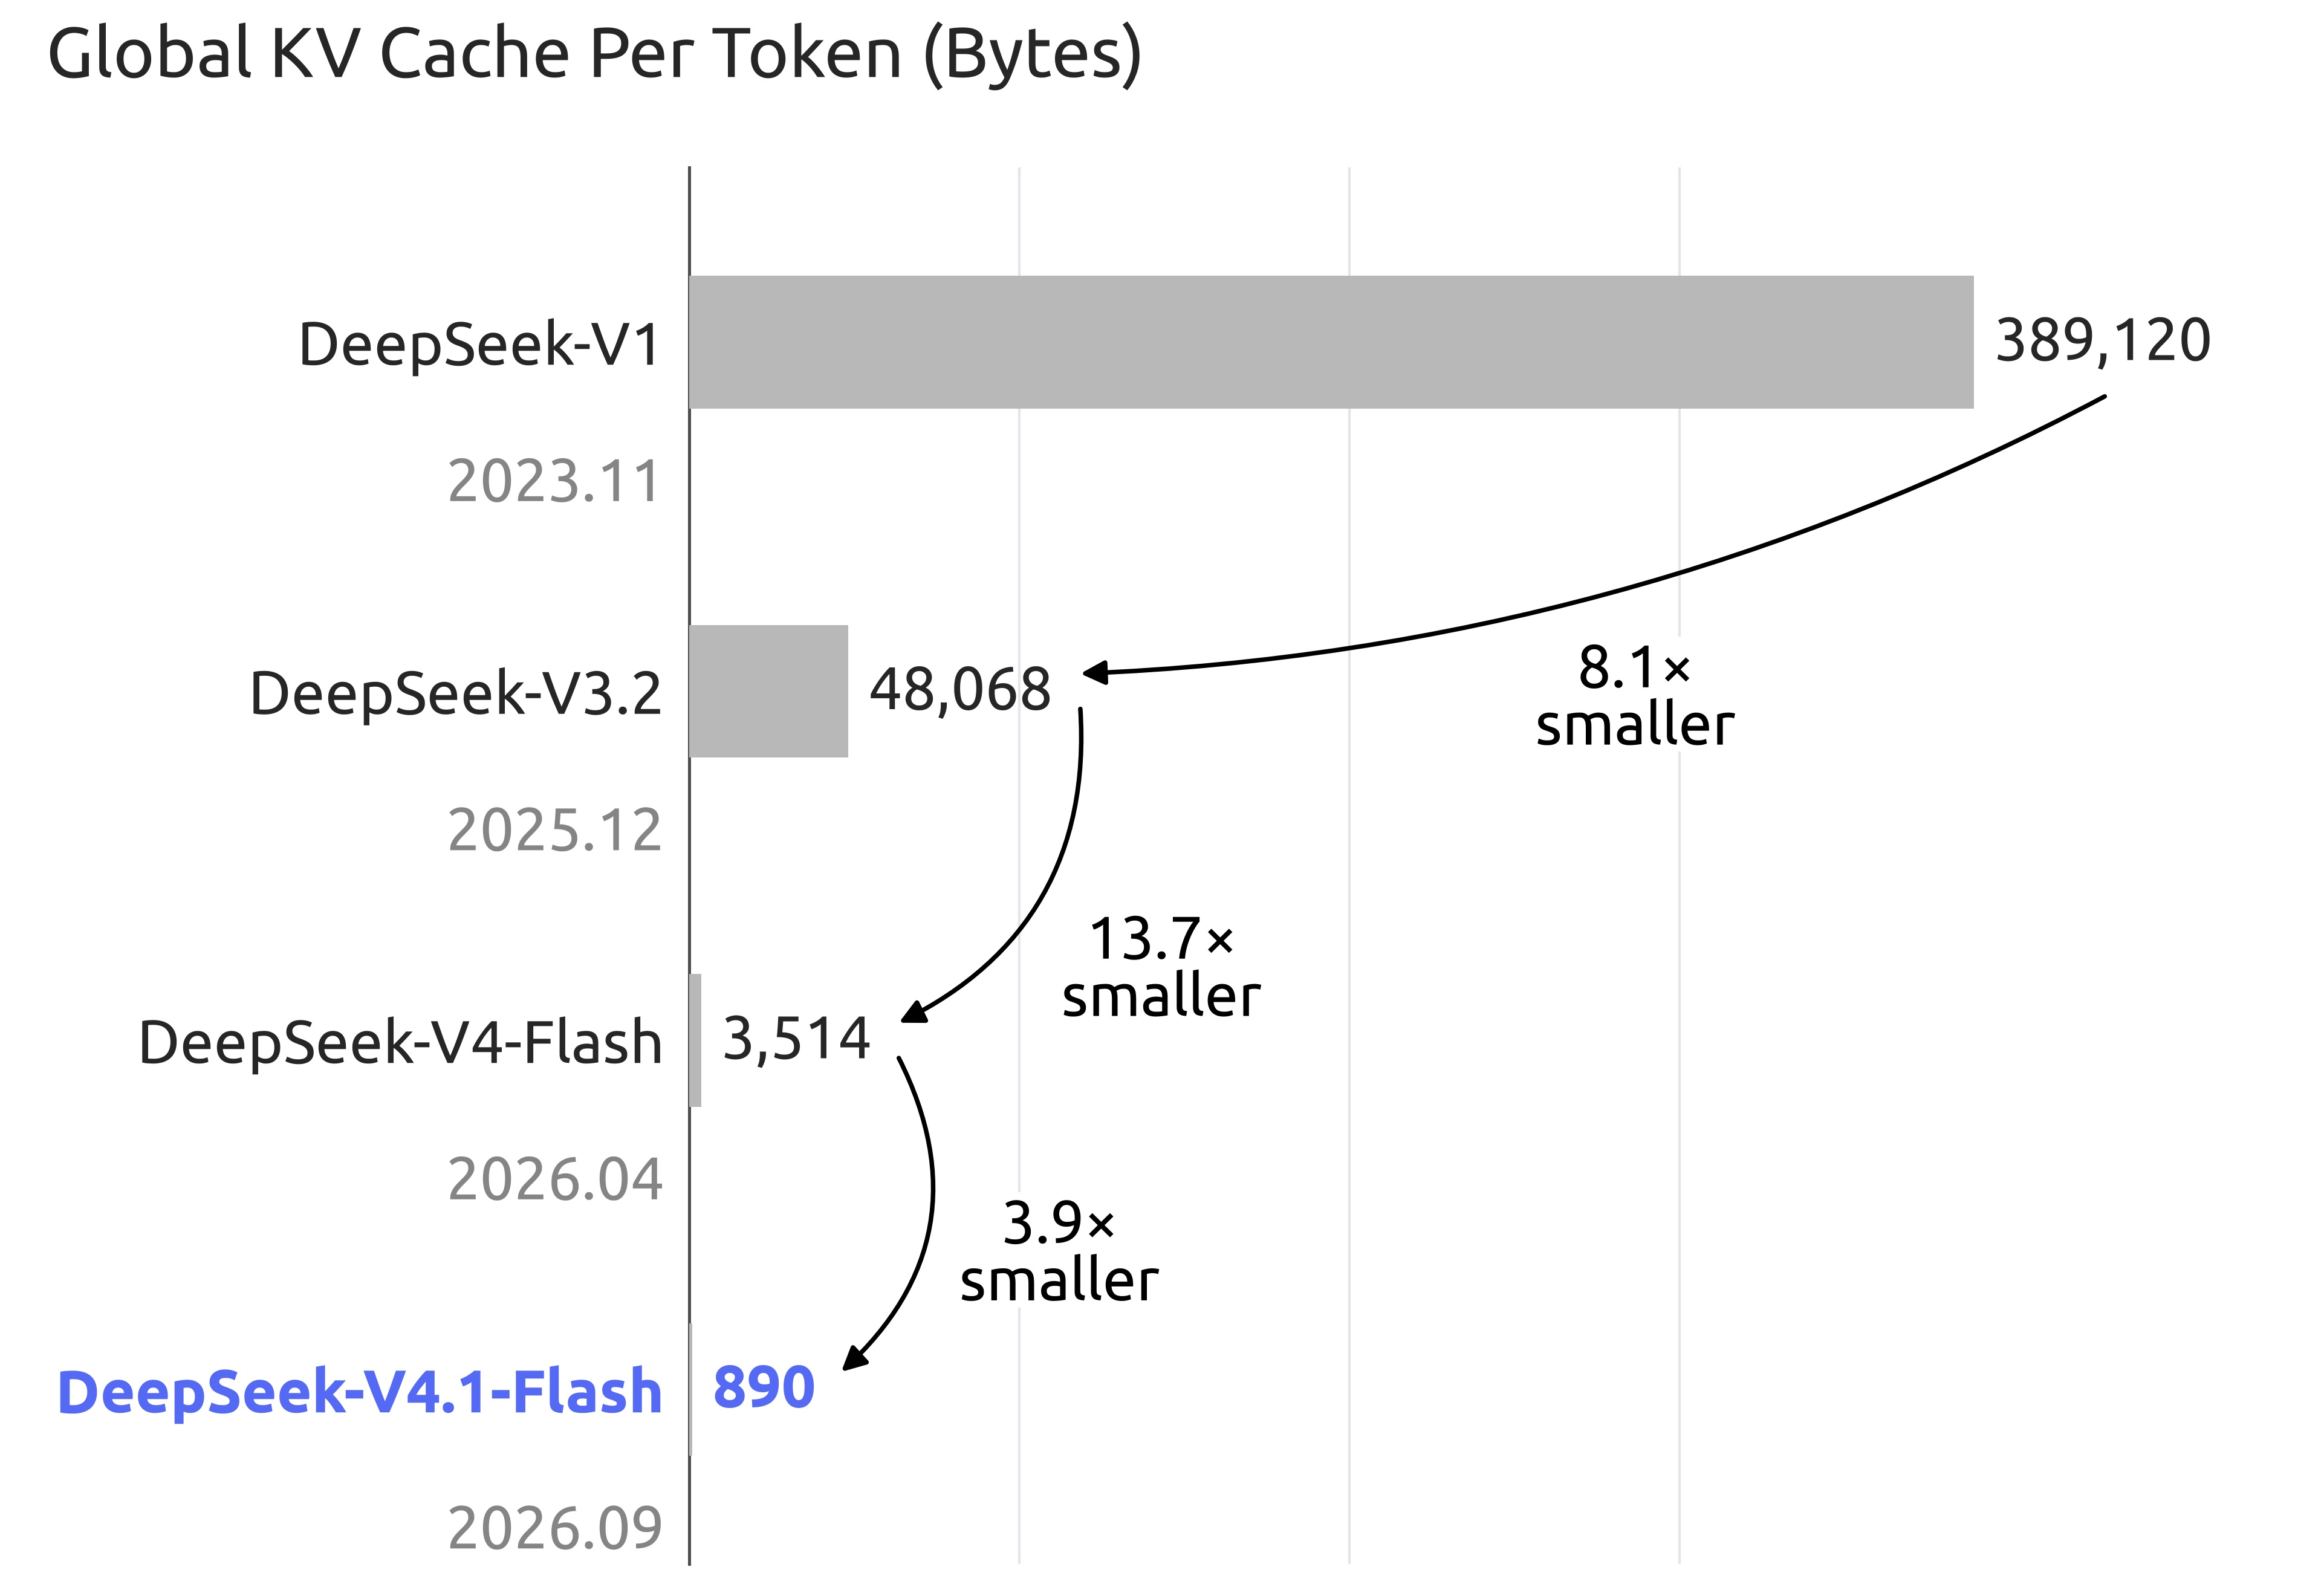
Wat de cachegrafiek laat zienHet gaat om opgeslagen tussenresultaten per token.
DeepSeek vergelijkt in de afgebeelde grafiek de globale KV-cache van zijn modelgeneraties. Voor V4.1 Flash noemt het 890 bytes per token, tegenover 3.514 voor V4 Flash. Dat is bijna vier keer kleiner. Deze cachemaat is een technische vergelijking van DeepSeek en staat niet gelijk aan het totale geheugen dat nodig is om het model te draaien.
Verder bij de bron
Lees zelf de onderzoeken, uitleg en aankondigingen achter dit verhaal.